AWS Lambdaを使用したログ解析ハンズオン
AWS環境では、アプリケーションやシステムから出力されるログを効率的に収集・分析することが重要です。
この記事では、AWS LambdaとAmazon S3を利用して、ログファイルから「ERROR」を含むレコードのみを自動抽出する簡易的なログ解析環境を構築するハンズオンを紹介します。サーバレスアーキテクチャの基本的な構成を学びながら、AWSサービス連携の流れを確認できる内容となっています。
INDEX[非表示]
- 1.今回のゴール
- 2.システム構成
- 3.ハンズオンの流れ
- 4.ハンズオンを通して学んだこと
今回のゴール
今回のハンズオンでは、AWS LambdaとAmazon S3を組み合わせて最小構成のログ解析環境を構築します。 最終的に、
- S3へログファイルをアップロードする
- Lambdaが自動実行される
- 「ERROR」を含むログのみを抽出する
- 抽出結果を別フォルダへ保存する
という一連の処理を実現します。
システム構成
今回構築する環境の全体像は以下のとおりです。
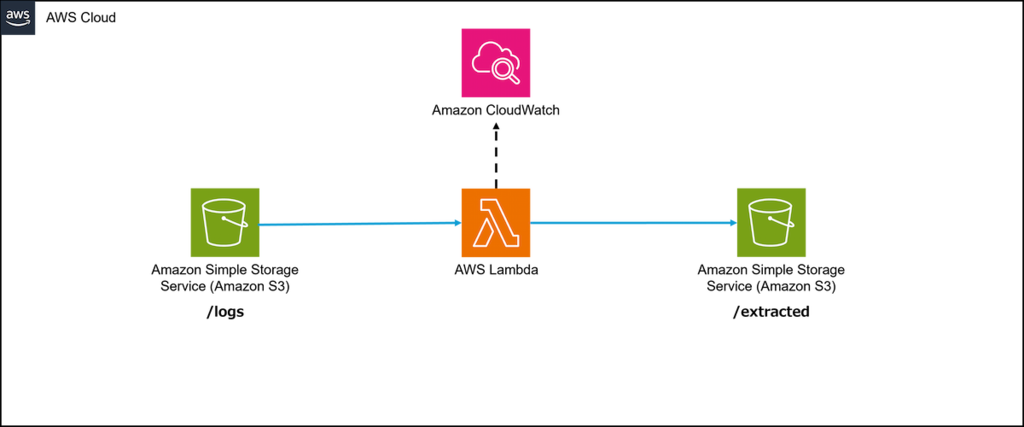
ログファイルを保存するS3バケットと、ログを解析するLambda関数を連携させるシンプルな構成です。ログアップロードをトリガーとしてLambdaが実行され、抽出結果を別フォルダへ出力します。
ハンズオンの流れ
構築は以下の手順で進めます。
- S3バケットの作成
- ログファイルのアップロード
- Lambda関数の作成
- IAMロール設定
- S3イベント通知設定
- 動作確認
Step1:S3バケットを準備する
まずはログファイルと抽出結果を保存するためのS3バケットを作成しました。
今回は入力ログと出力結果を明確に分けるため、バケット内に「logs」と「extracted」の二つのフォルダを用意しています。
- logs:アップロードしたログファイルを保存
- extracted:抽出結果を保存
入力領域と出力領域を分離しておくことで、後述するLambda関数の再実行ループを防ぎやすくなります。
Step2:サンプルログをアップロードする
続いて、動作確認用のログファイルを準備しました。 今回はJSON形式のログを使用し、INFOレベルとERRORレベルのメッセージを含むシンプルなサンプルファイルを「logs」フォルダへアップロードします。
【サンプル】
{ "time": "2025-10-07T10:00:00Z", "level": "INFO", "message": "Start" }
{ "time": "2025-10-07T10:01:00Z", "level": "ERROR", "message": "Connection timeout" }
{ "time": "2025-10-07T10:02:00Z", "level": "INFO", "message": "Retry succeeded" }
今回のハンズオンでは、このファイルの中から「ERROR」を含むレコードのみを抽出することを目標としました。
Step3:Lambda関数を作成する
ログ解析処理の中心となるのがAWS Lambdaです。 Lambda関数はPython 3.12を利用して作成し、S3へファイルが配置されたタイミングで自動実行されるよう構成しました。
今回実装した処理の流れはシンプルです。
- S3のlogsフォルダ配下のファイルを取得
- JSONログを読み込み
- ERRORを含むレコードを抽出
- 結果をJSON Lines形式で出力
- extractedフォルダへ保存
この構成により、ログのアップロードから解析結果の保存までをサーバーレスで自動化できます。
また、実装時には誤ったイベント連鎖を防ぐために、extracted配下のファイルが再度処理対象にならないよう制御を組み込みました。これにより無限ループの発生を防止しています。
【サンプルコード①】
import os
import io
import re
import json
import gzip
from typing import Iterator, Any
from urllib.parse import unquote_plus
import boto3
s3 = boto3.client("s3")# ====== 環境変数(必要に応じて変更)======
SRC_PREFIX    = os.environ.get("SRC_PREFIX", "logs/")
DST_PREFIX    = os.environ.get("DST_PREFIX", "extracted/")
OUT_SUFFIX    = os.environ.get("OUT_SUFFIX", "_extracted.jsonl")
TARGET_KEY    = os.environ.get("TARGET_KEY", "level")   # 例: "level" or "message"
TARGET_MATCH  = os.environ.get("TARGET_MATCH", "ERROR") # 部分一致
TARGET_REGEX  = os.environ.get("TARGET_REGEX")          # 例: r"(?i)(error|timeout|failed)"# ========================================
_regex = re.compile(TARGET_REGEX) if TARGET_REGEX else Nonedef _open_body_stream(obj_body) -> io.BufferedReader:
    """    S3のStreamingBodyを一旦bytes化してBufferedReader化。    gzipなら解凍して返す。seekは使わない(StreamingBodyは非対応のため)。    """
    body_bytes = obj_body.read()
    # GZIPマジック 1F 8B
    if len(body_bytes) >= 2 and body_bytes[0] == 0x1F and body_bytes[1] == 0x8B:
        return io.BufferedReader(gzip.GzipFile(fileobj=io.BytesIO(body_bytes)))
    return io.BufferedReader(io.BytesIO(body_bytes))

def _iter_json_records_from_text(text: str) -> Iterator[Any]:
    """    入力文字列を、単一JSON(配列/オブジェクト)→失敗ならNDJSONとして解釈。    """
    text = text.strip()
    if not text:
        return
    # 1) 単一JSON(配列 / オブジェクト)としてトライ
    try:
        obj = json.loads(text)
        if isinstance(obj, list):
            for item in obj:
                yield item
            return
        else:
            # 1オブジェクト
            yield obj
            return
    except json.JSONDecodeError:
        pass
    # 2) NDJSON(1行=1JSON)として行ごとに解釈
    for line in text.splitlines():
        line = line.strip()
        if not line:
            continue
        try:
            yield json.loads(line)
        except json.JSONDecodeError:
            # 破損行はスキップ(必要ならCloudWatchに詳細出力)
            continue
【サンプルコード②】
def _iter_json_records(body_stream: io.BufferedReader) -> Iterator[dict]:
    """    テキスト化した後、上記ロジックでレコードをyield。    デコードはUTF-8前提(壊れた箇所は置換)。    """
    text = body_stream.read().decode("utf-8", errors="replace")
    for rec in _iter_json_records_from_text(text):
        if isinstance(rec, dict):
            yield rec
def _is_match(rec: dict) -> bool:
    """    抽出条件:      - TARGET_KEY がセットされていれば rec[TARGET_KEY] の値を対象に判定      - そうでなければ rec 全体(JSON文字列)で判定    判定方法:      - TARGET_REGEX があれば正規表現      - なければ TARGET_MATCH の部分一致    """
    if TARGET_KEY:
        val = rec.get(TARGET_KEY, "")
        target_text = "" if val is None else str(val)
    else:
        target_text = json.dumps(rec, ensure_ascii=False)
    if _regex:
        return bool(_regex.search(target_text))
    if TARGET_MATCH:
        return TARGET_MATCH in target_text
    # 条件未指定なら全件通す
    return Truedef _build_out_key(src_key: str) -> str:
    """    logs/... → extracted/... に置換し、拡張子差し替え    """
    # logs/ を剥がした残りを tail として利用
    tail = src_key[len(SRC_PREFIX):] if src_key.startswith(SRC_PREFIX) else src_key
    # 拡張子を落として OUT_SUFFIX を付与
    if tail.endswith(".json"):
        tail = tail[:-5]
    elif tail.endswith(".jsonl"):
        tail = tail[:-6]
    return f"{DST_PREFIX}{tail}{OUT_SUFFIX}"

def lambda_handler(event, context):
    results = []
    for record in event.get("Records", []):
        bucket = record["s3"]["bucket"]["name"]
        key    = unquote_plus(record["s3"]["object"]["key"])
        # 再帰/想定外の発火を即時スキップ(一次防衛)
        if key.startswith(DST_PREFIX):
            print(f"skip output area: {key}")
            continue
        if not key.startswith(SRC_PREFIX):
            print(f"skip not under SRC_PREFIX ({SRC_PREFIX}): {key}")
            continue
        # 取得→デコード→レコード列挙
        obj = s3.get_object(Bucket=bucket, Key=key)
        stream = _open_body_stream(obj["Body"])
        matched_lines = []
        for rec in _iter_json_records(stream):
            if _is_match(rec):
                # 出力はJSON Linesで統一(1件=1行)
                matched_lines.append(json.dumps(rec, ensure_ascii=False))
        if not matched_lines:
            print(f"no matches: {key}")
            continue
        out_key = _build_out_key(key)
        s3.put_object(
            Bucket=bucket,
            Key=out_key,
            Body=("\n".join(matched_lines)).encode("utf-8"),
            ContentType="application/json"
        )
        results.append({
            "src": f"s3://{bucket}/{key}",
            "dst": f"s3://{bucket}/{out_key}",
            "count": len(matched_lines)
        })
    return {"ok": True, "results": results}
Step4:IAMロールで必要な権限を付与する
Lambda関数がS3へアクセスできるよう、IAMロールの設定もおこないます。 今回必要となる権限は以下のとおりです。
- ログファイルの取得
- バケット内オブジェクトの参照
- extractedフォルダへの出力
一方で、入力元であるlogsフォルダへの書き込みは明示的に禁止しました。 Lambdaの出力先を誤って入力領域にしてしまうと、新たなイベントが発火して処理が繰り返される可能性があります。そのため、IAMポリシーでも安全対策を実施しています。
【追加するロール】
{"Version": "2012-10-17","Statement": [
    {
      "Effect": "Allow",
      "Action": ["s3:GetObject", "s3:ListBucket"],
      "Resource": ["arn:aws:s3:::lambda-s3-log-demo", "arn:aws:s3:::lambda-s3-log-demo/*"]
    },
    {
      "Effect": "Allow",
      "Action": "s3:PutObject",
      "Resource": "arn:aws:s3:::lambda-s3-log-demo/extracted/*"
    },
    {
      "Effect": "Deny",
      "Action": "s3:PutObject",
      "Resource": "arn:aws:s3:::lambda-s3-log-demo/logs/*"
    }]}
Step5:S3イベント通知を設定する
Lambda関数を作成しただけでは自動実行されないため、S3のイベント通知機能を利用し、「logsフォルダへJSONファイルがアップロードされたとき」にLambdaが起動するよう設定しました。
今回の設定では、
- イベントタイプ:すべてのオブジェクト作成イベント
- Prefix: logs/
- Suffix: .json
- 宛先: Lambda (Step3で作成したリソース)
を条件としています。 これにより、対象ログがアップロードされた場合のみ処理が実行されるようになります。
Step6:動作確認
設定が完了したら、実際にログファイルをアップロードして動作を確認します。
logsフォルダへサンプルログを配置すると、S3イベント通知によってLambda関数が自動的に実行されます。
数秒後、extractedフォルダに抽出結果が生成されました。CloudWatch Logsを確認すると、処理が正常に実行されていることも確認できます。
出力されたファイルを確認すると、ERRORレベルのレコードのみが抽出されており、想定どおりの結果となりました。
ハンズオンを通して学んだこと
今回のハンズオンでは、AWS LambdaとAmazon S3だけでもシンプルなログ解析環境を構築できることを確認できました。
今回紹介した構成はシンプルですが、CloudWatch LogsやAmazon EventBridgeなどのサービスと組み合わせることで、より高度なログ分析基盤へ発展させることもできます。
AWSのサーバレスサービスに触れたことがない方は、まずはこのような小規模なハンズオンから試してみるのがおすすめです。